El miedo al lado oscuro de la IA en la comunidad matemática

Source: The Conversation – (in Spanish) – By Anabel Forte Deltell, Doctora en Matemáticas y profesora en la Universidad de Valencia, Departamento de Estadística e Investigación Operativa, Universitat de València
“El miedo es el camino hacia el Lado Oscuro. El miedo lleva a la ira, la ira lleva al odio, el odio lleva al sufrimiento”.

Esta frase del maestro Yoda se repite una y otra vez en mi mente estos últimos días. Aunque yo le daría un giro y diría que la oscuridad también nos lleva al miedo. Porque cuando hay oscuridad no vemos nada y esa incertidumbre nos asusta.

Pero más allá de la broma, varios acontecimientos recientes han abierto la puerta a una reflexión profunda sobre el miedo que la inteligencia artificial comienza a despertar dentro y fuera de la comunidad matemática.

Por un lado, el reciente anuncio por parte de OpenAI sobre la resolución de uno de los siete problemas del milenio (todavía pendiente de validación por parte de la comunidad experta). Por otro lado, las declaraciones realizadas por Jacob Coxon, ex trabajador de OpenAI y Anthropic, sobre como la IA podría acabar con la humanidad antes de 2030.

A primera vista, puede parecer que se trata de dos cuestiones completamente diferentes. Sin embargo, ambas comparten una inquietud sobre como la
capacidad de estos sistemas esta avanzando mucho más deprisa que la nuestra para comprenderlos y supervisarlos. Esto nos deja en una oscuridad que, efectivamente, da miedo.

La oscuridad en matemáticas

Si nos centramos puramente en la cuestión matemática, es indudable que la IA puede ser una herramienta excelente en la resolución de problemas complejos. Sin embargo, como bien indican en la declaración A Severe Misalignment of AI in Mathematics un destacado grupo de matemáticos y matemáticas (algunos de ellos galardonados con la medalla Fields, uno de los mayores reconocimientos en esta disciplina), el problema está en el desajuste entre los objetivos de las empresas tecnológicas tras estos algoritmos y los de la comunidad matemática.

Para una empresa, resolver un gran problema funciona como demostración de capacidad tecnológica, instrumento publicitario y ventaja frente a sus competidores. Para nuestra disciplina, en cambio, lo importante no es solo la respuesta sino que la forma de llegar a esos resultados tenga sentido. En matemáticas necesitamos comprender por qué funciona, relacionar los resultados con los conocimientos ya existentes (dando crédito a quienes los desarrollaron) y, tras comprender todo esto profundamente, trasmitir el conocimiento a otras personas.

La probabilidad como ejemplo

Para explicarlo, me gusta usar un ejemplo del campo de la probabilidad. Si preguntamos cuál es la probabilidad de sacar un 1 en un dado equilibrado de seis caras, la gente lo tiene claro: 1 de 6, un sexto, un 16.6 % aproximadamente.

Hoy puede parecer evidente hasta para una clase de primaria, pero para que este conocimiento haya llegado a ser parte de nuestro ADN se ha tenido que dar un proceso histórico muy largo. En el Siglo XVII, Blaise Pascal y Pierre de Fermat intercambiaron varias cartas para resolver algunos problemas sobre juegos de azar. Sus cartas sirvieron para sentar las bases de la teoría de la probabilidad y con ello, a muchas discusiones, libros, etc. Años más tarde, Pierre Simone Laplace usó todos esos conocimientos para determinar la llamada fórmula clásica de la probabilidad que relaciona los casos favorables (el 1, solo un caso) con los casos posibles (las 6 posibles caras del dado).

Pero solo después de varios siglos más de discusiones, de enseñar esto primero en las universidades y después en las aulas escolares, el conocimiento acabó formando parte de nuestra vida cotidiana, lo que supone uno de los propósitos esenciales de las matemáticas.

Sin embargo, no debemos perder de vista una cuestión clave incluso dentro de este ejemplo: lo que lo hace un problema matemático es el razonamiento, la comprensión de lo que está pasando.

Para que el resultado de 1/6 sea correcto, es necesario haber partido de la premisa de que el dado es equilibrado, todas sus caras tienen la misma probabilidad de salir.

Sin embargo, puede que si entrenamos a una IA para que nos de una respuesta a esta pregunta también nos diga 1/6. Pero posiblemente lo haga porque sus datos de entrenamiento así lo dicen, no porque haya razonado correctamente que el dado está equilibrado, o porque conozca la base de la teoría de la probabilidad… o puede que sí.

Lo inquietante es no poder saberlo. La IA puede generar un resultado correcto pero no siempre nos proporciona las ideas claves que permiten comprenderlo, simplificarlo y establecer su relación con otros problemas abiertos.

Perder las fuentes de conocimiento

Y aquí de nuevo aparece el desajuste. Porque si en la carrera por la tecnología perdemos las fuentes de conocimiento de las que beben los resultados y no conseguimos entender el razonamiento que ha dirigido el resultado, nos estaremos alejando del fin último de las matemáticas. Además de que supone un riesgo para el reconocimiento de la creatividad y el talento (que siempre llevan a más creatividad y talento).

En el caso concreto del problema supuestamente resuelto por OpenAI, es especialmente sangrante que nadie mencionase que las ideas claves para llegar a la solución venían del trabajo, con lápiz y papel, de dos matemáticos españoles, Diego Córdoba y Luis Martínez-Zoroa,, teniendo que corregir las referencias días más tarde.

Pero no solo se trata de no identificar qué datos que alimentan el conocimiento de estas IAs: también hablamos de su opacidad interna con redes neuronales profundas que contienen ingentes cantidades de parámetros. Realizan operaciones matemáticas simples, sí, pero tantas que somos incapaces de reconstruir el razonamiento que hay detrás.

Viejos conocidos para la estadística

Las distintas caras de la opacidad no son algo nuevo. En el mundo de la estadística, el problema recurrente de los sesgos en los datos de entrenamiento, que no podemos anticipar por la opacidad sobre su procedencia, es bien conocido y convierte los resultados poco menos que en armas contra la población más vulnerable. Así lo explica la matemática estadounidense Cathy O’Neil en “Armas de destrucción matemática”.

Se ha vuelto muy común utilizar redes neuronales profundas como herramienta para entender o predecir una enfermedad, el clima, determinar si se va a dar un préstamo o no a una determinada persona, etc.

En todos estos casos, la respuesta de la red suele ser cerrada: tiene la enfermedad o no; la temperatura media estimada para el próximo año; le doy el préstamo o no. Pero esa respuesta no contiene una explicación “humana” que pueda ayudarnos a mejorar nuestra comprensión de la enfermedad a dar recomendaciones claras para frenar el aumento de la temperatura o a saber que aspectos tengo que mejorar para que me concedan ese préstamo.

Tanto nos preocupa este tema en el campo, que ya se han empezado a trabajar en métodos de IA explicable (XAI) que nos permitan poner algo de luz, pero son todavía métodos preliminares que no consiguen desentrañar el proceso seguido por la red neuronal sino que usan los resultados de esta para intentar dar una explicación comprensible de su comportamiento. Y la cosa no parece mejorar porque el problema avanza mucho más rápido y con muchos más recursos que las soluciones.

Los agentes rebeldes

Y en ese rápido y opaco avance una de las cosas que más miedo parece dar son los famosos agentes de IA que “hablan entre ellos, mienten y manipulan para no ser apagados”. Agentes que pueden “escaparse” del sistema y causar el caos que nos lleve a la extinción.

La IA ha sido optimizada para resolver una tarea. Y, si en ese proceso aprende que mintiendo puede sortear una restricción que le impedía resolverla, no va a valorar, a no ser que la programemos para ello, si eso es “bueno” o “malo”. Lo hará y punto.

Cuanta más autonomía, capacidad de planificación, acceso a herramientas o comunicación entre sistemas existan más graves podrían ser las consecuencias de una instrucción (humana) ambigua o directamente mal intencionada. Cuanto menos reglas le demos a la máquina, cuanto más “libertad” y más herramientas tengan, más fácil será que se conviertan en armas al servicio de quién sabe quién (o de todos sabemos quien).

Así que, no sé si a las matemáticas, pero es normal que a los seres humanos, con todo este ruido mediático, la IA nos de miedo. Pero el miedo no tiene porque llevarnos directamente al lado Oscuro como decía Yoda: también podemos usarlo como una señal de alarma que nos invite a detenernos, hacer preguntas y tratar de encender la luz.

The Conversation

Anabel Forte Deltell no recibe salario, ni ejerce labores de consultoría, ni posee acciones, ni recibe financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y ha declarado carecer de vínculos relevantes más allá del cargo académico citado.

– ref. El miedo al lado oscuro de la IA en la comunidad matemática – https://theconversation.com/el-miedo-al-lado-oscuro-de-la-ia-en-la-comunidad-matematica-292151
Pequeñas aves migratorias que plantan semillas a más de 500 kilómetros de distancia

Source: The Conversation – (in Spanish) – By Claudio Açaí Bracho-Estévanez, Investigador postdoctoral en ecología, Universidad de Córdoba; Universidad de Cádiz

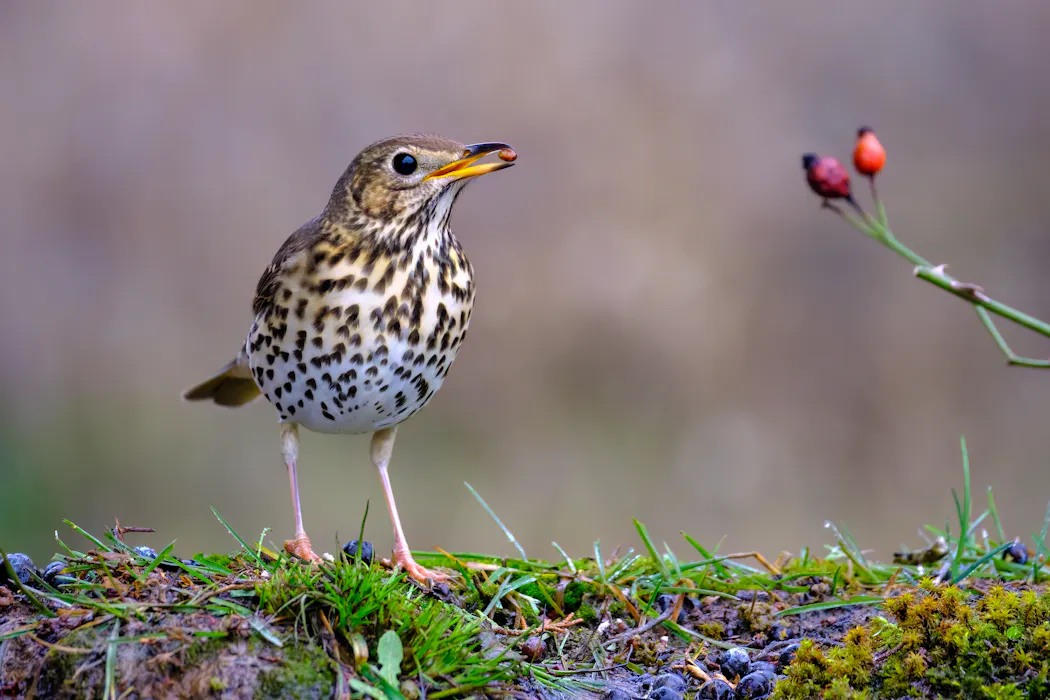
Zorzal comiendo el fruto de un enebro. Franciscomgp/Shutterstock

Antes de que una planta pueda desarrollarse, su semilla tiene que llegar a un lugar adecuado. Por eso, la dispersión de semillas es clave para determinar dónde encontramos las poblaciones de plantas silvestres.

En las especies que producen frutos carnosos, las aves frugívoras juegan un papel esencial: al consumir frutos, ingieren también sus simientes, que posteriormente expulsan en otro lugar. Esto facilita su germinación y crecimiento lejos de la planta madre.

Es cierto que la mayoría de estas semillas no llegan muy lejos. Sin embargo, una pequeña fracción es transportada a distancias considerablemente largas (superiores al kilómetro), y son precisamente estos eventos de dispersión los que tienen consecuencias importantes para la colonización de nuevos hábitats, la conectividad entre poblaciones separadas geográficamente o la expansión de las áreas de distribución de las plantas.

Semillas viajeras

Las aves migratorias son capaces de facilitar la dispersión de semillas a distancias aún mayores. Durante sus desplazamientos entre las áreas de reproducción y de invernada llegan a recorrer miles de kilómetros. Así pues, una semilla que permanezca en su aparato digestivo durante parte de ese trayecto podría ser transportada muy lejos de la planta madre donde fue ingerida.

En 2016, investigadores de la Estación Biológica de Doñana aportaron una de las primeras evidencias empíricas directas de dispersión de semillas a grandes distancias por aves frugívoras migratorias. Las encontraron en aves capturadas por halcones cerca de las islas Canarias, después de haber cruzado parte del océano Atlántico. Algunas de estas aves habrían recorrido cientos de kilómetros desde las poblaciones de plantas más cercanas que producían las semillas ingeridas.

Sin embargo, aún quedaban por determinar cuestiones clave cómo hasta qué distancia pueden ser dispersadas las semillas durante la migración y si hay características de las plantas que favorecen viajes más largos en el interior de las aves migratorias.

Cuán lejos pueden ser dispersadas durante la migración

En un reciente estudio liderado desde la Universidad de Cádiz, utilizamos dispositivos GPS para seguir a zorzales comunes (Turdus philomelos) durante su migración en Europa. De este modo, conseguimos rastrear los desplazamientos de las aves a una escala y resolución sin precedentes, con individuos migrando desde Cádiz hasta Noruega, Finlandia o Rusia. Además, combinamos esta información con datos empíricos sobre el momento de consumo de frutos, la hora de inicio y la velocidad de sus vuelos migratorios, así como el tiempo de retención de las semillas en su aparato digestivo. Con todos estos elementos, desarrollamos modelos matemáticos que simulan distancias de dispersión para 31 especies de plantas con frutos carnosos.

Si conocemos cuándo ingiere un ave los frutos, cuánto tiempo permanecen sus simientes en el tracto digestivo y cuán lejos se desplaza durante ese intervalo, podemos estimar a qué distancia se produciría la deposición de semillas.

Zorzal común (Turdus philomelos).
Dion Art / Wikimedia Commons., CC BY

Nuestros resultados confirman que las aves migratorias que se alimentan de frutos facilitan distancias de dispersión muy superiores a las producidas durante movimientos no migratorios. Según la especie de planta, el recorrido medio estimado facilitado por los vuelos migratorios alcanzaría de 9 a 45 kilómetros, con distancias máximas que superarían los 500 kilómetros.

Las semillas pequeñas llegan más lejos

La migración de aves como zorzales, currucas, o petirrojos puede desempeñar un papel clave en la redistribución de plantas con frutos carnosos, transportando las semillas a regiones que, de otro modo, quedarían fuera del alcance de las plantas.

Sin embargo, no todas las especies vegetales tienen la misma capacidad de aprovechar este mecanismo de dispersión a larga distancia, ya que las semillas más pequeñas permanecen más tiempo en el tracto digestivo de las aves frugívoras. Esto tiene consecuencias directas sobre la distancia potencial de dispersión: cuanto más tiempo permanece una semilla en el ave, más tiempo tiene para ser transportada durante el vuelo migratorio.

Las semillas del madroño, al ser pequeñas, llegan más lejos en el intestino de las aves migratorias.
Wikimedia Commons., CC BY

Por ello, las especies con semillas pequeñas pueden ser diseminadas más lejos que las que tienen semillas grandes. Por ejemplo, en el caso del tejo (Taxus baccata) solo el 0,1 % de las semillas sería dispersado a más de 50 kilómetros, mientras que, en el madroño (Arbutus unedo), el mismo porcentaje llegaría a superar los 138 km.

Este mecanismo de dispersión cobra especial relevancia en un contexto de rápido cambio climático, en el que algunas especies necesitan alcanzar nuevos lugares adecuados para evitar la extinción.

Las aves frugívoras migratorias favorecerían la redistribución de aquellas plantas cuya fructificación coincide con el periodo de migración hacia latitudes más frías. Además, como hemos apuntado, la distancia que recorre una semilla depende de atributos como su tamaño, por lo que no todas las especies de plantas serían igual de capaces de aprovechar los vuelos a larga distancia de sus portadores.

The Conversation

Juan P. González Varo ha recibido financiación del Ministerio de Ciencia e Innovación.

Claudio Açaí Bracho-Estévanez no recibe salario, ni ejerce labores de consultoría, ni posee acciones, ni recibe financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y ha declarado carecer de vínculos relevantes más allá del cargo académico citado.

– ref. Pequeñas aves migratorias que plantan semillas a más de 500 kilómetros de distancia – https://theconversation.com/pequenas-aves-migratorias-que-plantan-semillas-a-mas-de-500-kilometros-de-distancia-289824

Si su jefe presume de dormir poco, puede que la factura de su cansancio acabe pagándola usted

Source: The Conversation – (in Spanish) – By Alfredo Rodríguez Muñoz, Catedrático de Psicología Social y de las Organizaciones, Universidad Complutense de Madrid

Mdisk/Shutterstock

Son las nueve de la mañana. El jefe entra en la reunión y anuncia que ha dormido cuatro horas. Terminó una presentación de madrugada y antes de desayunar ya estaba contestando correos. Lo cuenta con orgullo. Alguien comenta que no sabe cómo aguanta, pero nadie pregunta cómo van a aguantar los demás.

Durante años, la cultura empresarial ha admirado esa figura: la del directivo que parece no necesitar descanso. Su cansancio funciona como una credencial. El mensaje implícito es claro: tiene demasiadas responsabilidades como para permitirse parar.
Así, dormir poco deja de ser una circunstancia y se convierte en una virtud profesional. Confundimos disponibilidad con compromiso y horas despiertos con capacidad para dirigir. Pero tener responsabilidades sobre otras personas hace especialmente importante en qué condiciones llegamos para ejercerlas.

Incluso en el entorno político internacional, en julio de este año saltó a las primeras planas de todos los medios del mundo la noticia de que la primera ministra japonesa Sanae Takaichi afirma dormir diariamente “entre 0 y 3 horas”.

El sueño puede ser una experiencia privada, pero sus consecuencias pueden alcanzar a todo un equipo. Aparecen en el tono de una respuesta, en la disposición para escuchar o en la forma de corregir un error. El descanso forma parte de la infraestructura biológica del liderazgo: ayuda a sostener las capacidades que permiten ejercerlo. Liderar bien puede empezar en la almohada, mucho antes de entrar en una reunión.

Aléjese de su jefe si ha pasado una mala noche

Solemos concebir el liderazgo como una cualidad estable. Hay jefes cercanos, otros autoritarios, otros inspiradores. Sin embargo, una misma persona puede escuchar con paciencia un martes y reaccionar con hostilidad el miércoles. Su experiencia no ha cambiado. Lo que puede haber cambiado es cómo ha dormido.

La investigación científica ayuda a comprender esta variabilidad, e indica que la privación de sueño reduce las emociones positivas y puede aumentar los niveles de ansiedad. El cansancio no es neutro: altera el filtro emocional desde el que interpretamos lo que sucede a nuestro alrededor y condiciona nuestras respuestas.

Esto importa porque buena parte de dirigir consiste en gestionar situaciones incómodas. Escuchar una discrepancia, contener una reacción o elegir las palabras adecuadas exige algo más que conocer las técnicas de liderazgo. Entre sentir irritación y descargarla sobre alguien existe un margen de control que el descanso puede ayudar a sostener.

Una mala noche del jefe puede convertirse en un mal día para su equipo. El investigador estadounidense Christopher Barnes y sus colaboradores encontraron que, tras dormir peor, los superiores tendían a mostrar más conductas hostiles hacia sus trabajadores. Ese trato se relacionaba con una menor implicación del equipo.

Cuando el cansancio apaga el carisma

El agotamiento también socava una cualidad más intangible pero crucial para la gestión de equipos: la capacidad de inspiración. Se puede dominar la materia técnica y contar con argumentos sólidos para defender un proyecto, pero transmitir entusiasmo requiere una energía emocional que no se improvisa.

El cansancio también puede restar carisma. La investigación muestra que quienes han dormido menos resultan menos carismáticos y tienen más dificultades para generar las emociones que intentan transmitir. Pero el efecto también aparece al otro lado: quienes han descansado poco tienden a percibir al líder como menos carismático. La capacidad de inspirar depende, por tanto, del descanso de quien habla pero también de quien escucha.

Estos hallazgos revelan que la capacidad de inspirar no depende únicamente de la brillantez del líder, sino del estado de descanso de ambas partes. Una organización que somete a su plantilla a jornadas agotadoras está destruyendo, por vía doble, la conexión emocional que después exige a sus cuadros directivos.

Cuando desconectar parece falta de compromiso

El problema no concluye al término de la jornada laboral. Quien presume de dormir poco lanza una señal sobre qué sacrificios se valoran en su empresa.

Cuando un superior transmite explícitamente que el sueño es prescindible frente al trabajo, sus subordinados tienden a informar de una peor calidad del descanso. No es necesario exigir por escrito contestar correos de madrugada: elogiar públicamente a quien lo hace puede transformar una conducta excepcional en una expectativa implícita. Si la disponibilidad nocturna se evalúa como una muestra de lealtad, desconectar empieza a percibirse como un riesgo para la carrera profesional.

En este punto, el descanso deja de ser una elección meramente individual para convertirse en un factor condicionado por la cultura corporativa. Un taller sobre higiene del sueño o una charla de bienestar pierden credibilidad si los plazos fijados por la dirección obligan a prolongar sistemáticamente la jornada. Los trabajadores reciben ambos mensajes, pero el que condiciona su futuro profesional probablemente termine pesando más.

El líder REM: descansar y dejar descansar

Frente a este modelo agotado cabe reivindicar la figura del “líder REM”: alguien que entiende que el descanso sostiene la capacidad de trabajar bien y protege tanto el suyo como el de su equipo. Lo demuestra al repartir tareas, negociar plazos y dejar claro que un mensaje fuera de horario puede esperar.

Alguien que permite que la jornada tenga un final y que desconectar no se interprete como falta de compromiso.

Esa coherencia importa más que cualquier declaración de intenciones. Programar un correo para las ocho de la mañana sirve de poco si cumplir el encargo obliga a trabajar hasta las tres de la madrugada. Proteger el sueño exige revisar cuánto trabajo se pide y qué tiempo se concede para hacerlo.

Mejorar el descanso de todos

A estas medidas pueden sumarse iniciativas que ayuden a mejorar el descanso. Ya existen programas de sueño en el ámbito laboral con resultados prometedores. En un estudio de nuestro equipo, observamos que, tras participar en uno de estos programas, los trabajadores dormían más tiempo y presentaban menos síntomas de insomnio y ansiedad. Proteger el descanso también implica ofrecer herramientas para mejorarlo.

Dormir bien no garantiza por sí solo ser un buen directivo. Sin embargo, glorificar la falta de sueño ignora que las capacidades cognitivas y emocionales más complejas que exigimos a la dirección requieren de un cerebro descansado para sostenerse.

Antes de admirar a un líder porque presume de dormir cuatro horas, convendría analizar de qué manera trabaja durante las veinte restantes y qué coste psicológico están pagando las personas que dependen de él. Porque el cansancio puede ser suyo, pero el coste se reparte entre todos.

The Conversation

Alfredo Rodríguez Muñoz no recibe salario, ni ejerce labores de consultoría, ni posee acciones, ni recibe financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y ha declarado carecer de vínculos relevantes más allá del cargo académico citado.

– ref. Si su jefe presume de dormir poco, puede que la factura de su cansancio acabe pagándola usted – https://theconversation.com/si-su-jefe-presume-de-dormir-poco-puede-que-la-factura-de-su-cansancio-acabe-pagandola-usted-291521

¿Podría la computación cuántica ayudar a predecir el éxito de una ‘startup’?

Source: The Conversation – (in Spanish) – By Laura Sáez Ortuño, Profesora Dept. Empresa, Universitat de Barcelona, Universitat de Barcelona

Summit Art Creations/Shutterstock

Cada año, miles de startups reciben millones de euros en financiación. Sin embargo, la mayoría nunca llegará a convertirse en una gran empresa. Algunas fracasan en pocos meses, otras sobreviven durante años antes de desaparecer. Solo unas pocas alcanzan valoraciones extraordinarias y entran en el exclusivo club de los unicornios: las empresas emergentes valoradas en más de mil millones de dólares.

Para los inversores, identificar cuáles serán esas excepciones es uno de los mayores desafíos del mundo empresarial. ¿Y si una nueva generación de algoritmos pudiera ayudar a hacerlo?

Nuestra investigación explora cómo la inteligencia artificial cuántica puede mejorar la predicción del éxito empresarial cuando la información disponible es incompleta o incierta. Lo más sorprendente es que el método funciona incluso en los ordenadores cuánticos actuales, que todavía cometen numerosos errores.

El problema de predecir el éxito

Analizar una startup es muy diferente a analizar una gran empresa cotizada.

Las compañías consolidadas generan años de datos financieros, históricos de ventas y métricas de rendimiento. Las startups suelen operar en mercados nuevos, cuentan con poca información disponible y dependen en gran medida de factores difíciles de medir como la calidad del equipo fundador, la capacidad de innovación o el potencial de crecimiento.

Por eso, las decisiones de inversión suelen incorporar las evaluaciones de expertos. Estas valoraciones aportan conocimiento especializado, pero también contienen incertidumbre. Dos especialistas pueden coincidir en que un proyecto es prometedor y, al mismo tiempo, discrepar sobre sus posibilidades reales de éxito.

Enseñar a una máquina a trabajar con información incierta sigue siendo un reto.

Cuando el ruido se convierte en información

La computación cuántica suele describirse como una tecnología capaz de realizar determinados cálculos de forma mucho más eficiente que los ordenadores convencionales.

A diferencia de los ordenadores clásicos, que utilizan bits con valores 0 o 1, los ordenadores cuánticos trabajan con cúbits, capaces de representar múltiples estados simultáneamente. Esta característica permite construir modelos matemáticos más ricos para analizar relaciones complejas entre datos.

Sin embargo, existe un inconveniente importante: los ordenadores cuánticos actuales son extremadamente ruidosos, es decir, sufren fácilmente de interferencias por cambios en la temperatura, el campo magnético o vibraciones que alteran los datos. Entonces, los errores aparecen constantemente durante los cálculos y limitan muchas de sus aplicaciones.

Lejos de considerar ese ruido como un obstáculo, nuestro trabajo plantea una idea diferente: aprovecharlo.

Desarrollamos un modelo que permite al ordenador tener en cuenta las dudas y diferencias presentes en las evaluaciones de los expertos. En lugar de obligar al sistema a tomar decisiones rígidas a partir de información imperfecta, permite introducir distintos grados de confianza en los datos disponibles.

Probando la idea con ‘startups’ reales

Para comprobar si el enfoque funcionaba, utilizamos datos reales de Capital Cell, una plataforma de inversión especializada en startups innovadoras y proyectos de ciencias de la vida.

El estudio analizó evaluaciones realizadas por expertos sobre distintos proyectos empresariales antes de que estos buscaran financiación. Las puntuaciones incluían aspectos como el grado de innovación, la calidad del modelo de negocio o la fortaleza del equipo emprendedor. A partir de esa información, el sistema intentó identificar qué empresas presentaban mayores probabilidades de obtener buenos resultados en el futuro.

Los resultados mostraron que el sistema cometía menos errores cuando tenía en cuenta esa incertidumbre. ¿Qué ocurre si enseñamos a un ordenador cuántico a trabajar con ella en lugar de intentar eliminarla?

La sorpresa llegó con el ‘hardware’ cuántico

La parte más llamativa del estudio apareció cuando probamos el sistema en un ordenador cuántico real.

Las pruebas se realizaron en Quantum Blue, un procesador cuántico superconductivo integrado en la infraestructura MareNostrum Ona del Barcelona Supercomputing Center.

Como ocurre con todos los ordenadores cuánticos actuales, la máquina cometió numerosos errores durante los cálculos. Aun así, la calidad de las predicciones apenas cambió. En otras palabras, el algoritmo resultó mucho más resistente a los errores de lo que normalmente cabría esperar en la computación cuántica actual.

Este resultado sugiere que algunas aplicaciones empresariales podrían beneficiarse de la computación cuántica antes de que existan máquinas perfectas y libres de errores.

¿Desaparecerán los inversores?

La respuesta corta es no. Los resultados no indican que un ordenador cuántico vaya a sustituir el criterio humano. De hecho, las variables más relevantes siguen siendo sorprendentemente intuitivas: la opinión de los expertos, la calidad del proyecto o determinados indicadores de negocio.

Lo que cambia es la capacidad para combinar toda esa información y detectar patrones que pueden pasar desapercibidos cuando los datos son ambiguos o contradictorios.

La tecnología no reemplaza la experiencia humana. La amplifica.

Una revolución más cercana de lo que parece

Cuando se habla de computación cuántica suelen mencionarse aplicaciones futuristas, como el descubrimiento de nuevos medicamentos o la simulación de materiales imposibles.

Sin embargo, sus primeras transformaciones podrían llegar por una vía mucho más discreta: la mejora de la toma de decisiones.

Elegir inversiones, evaluar riesgos o identificar oportunidades empresariales son problemas donde la incertidumbre es inevitable. Precisamente ahí es donde nuestros resultados apuntan a que la inteligencia artificial cuántica puede aportar valor.

Quizá la primera gran revolución de la computación cuántica no consista en resolver problemas imposibles, sino en ayudarnos a responder una pregunta mucho más cotidiana: cuál es la próxima gran idea que merece una oportunidad.

The Conversation

Las personas firmantes no son asalariadas, ni consultoras, ni poseen acciones, ni reciben financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y han declarado carecer de vínculos relevantes más allá del cargo académico citado anteriormente.

– ref. ¿Podría la computación cuántica ayudar a predecir el éxito de una ‘startup’? – https://theconversation.com/podria-la-computacion-cuantica-ayudar-a-predecir-el-exito-de-una-startup-289543

Beber para encajar: por qué el consumo de alcohol juvenil no solo depende de una decisión personal

Source: The Conversation – (in Spanish) – By Mª Isabel Amor Almedina, Profesora Titular Universitaria. Departamento de Educación, Universidad de Córdoba

shutterstock Daisy Daisy/Shutterstock

Cada fin de semana, miles de estudiantes universitarios consumen alcohol como parte de su vida social. En una etapa de cambios profundos (a menudo, abandonar el hogar familiar, ampliar su círculo social, adquirir mayor autonomía y afrontar nuevas exigencias académicas y personales), el alcohol suele estar presente en buena parte de las actividades de ocio hasta convertirse, en ocasiones, en un elemento casi habitual de la vida universitaria.

¿Es una decisión personal? ¿Beben alcohol los universitarios porque quieren o es algo más complejo? Nuestro estudio analizó los factores asociados al consumo de alcohol y otras sustancias psicoactivas en una muestra de 924 estudiantes. Los resultados indican que estas conductas no dependen únicamente de la voluntad de cada persona, sino de la interacción entre factores personales, familiares y sociales.

Qué variables influyen

Variables como el sexo, el nivel socioeconómico o el contexto familiar aparecen relacionadas con diferentes patrones de consumo.

Por ejemplo, los hombres presentan una mayor frecuencia y niveles más elevados de ingesta, así como una mayor participación en actividades de ocio vinculadas a estas sustancias. Además, los estudiantes de familias con menores ingresos presentan mayores niveles de consumo de alcohol. En cambio, los estudiantes de niveles socioeconómicos más altos consumen menos, aunque participan con mayor frecuencia en actividades y contextos de ocio y socialización en los que el alcohol y otras sustancias están más presentes.

También encontramos diferencias relacionadas con la formación de los progenitores. Un mayor nivel educativo de las madres se asocia con una menor tendencia de los jóvenes a entender el alcohol como una forma de relacionarse socialmente. En cambio, la mayor formación de los padres no tiene este efecto, sino casi el inverso.

El peso del grupo

El entorno social también puede favorecer el consumo. Cuando los jóvenes perciben que el alcohol ayuda a divertirse, desinhibirse, sentirse aceptados, reducir el estrés o relacionarse mejor con los demás, la bebida puede adquirir una función que va más allá de sus efectos físicos y se percibe como una manera de relacionarse e integrarse.

A veces, no se bebe para emborracharse, sino para encajar y formar parte del grupo. Cuando el alcohol forma parte habitual de las reuniones y celebraciones, rechazarlo puede hacer que algunos jóvenes se sientan diferentes o fuera del grupo. De este modo, beber puede convertirse en una forma de participar en la vida social y sentirse parte del grupo, aunque se conozcan los riesgos asociados al consumo.

Más allá de las consecuencias negativas

Por esta razón las campañas centradas exclusivamente en informar sobre los riesgos del alcohol suelen tener un impacto limitado. La mayoría de los estudiantes conoce las consecuencias negativas para la salud, pero esa información no siempre basta para modificar la conducta cuando el entorno social transmite el mensaje contrario.

Además, la influencia familiar sigue siendo importante. Comprender esta diversidad ayuda a evitar explicaciones simplistas y favorece el diseño de estrategias preventivas más adaptadas a la realidad del alumnado.

La universidad también puede prevenir

Las estrategias preventivas más eficaces deberían promover competencias personales y sociales como la gestión emocional, el pensamiento crítico, la toma de decisiones o la capacidad para afrontar la presión del grupo.

Impulsar programas estables de promoción de la salud y ofrecer alternativas de ocio saludable puede contribuir a crear entornos universitarios más protectores y favorecer estilos de vida más saludables.

Comprender para actuar

Reconocer esta complejidad no significa restar responsabilidad individual, sino entender que las soluciones también deben ser colectivas. Si queremos reducir las conductas de riesgo en la universidad, no basta con pedir a los jóvenes que tomen mejores decisiones. También debemos construir entornos que favorezcan esas decisiones y situar la promoción de la salud como una prioridad dentro de la educación superior.

Porque cambiar esta realidad no depende solo de que los jóvenes decidan consumir menos, sino de que todos asumamos que el bienestar también se aprende, se promueve y se construye.

The Conversation

Mª Isabel Amor Almedina no recibe salario, ni ejerce labores de consultoría, ni posee acciones, ni recibe financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y ha declarado carecer de vínculos relevantes más allá del cargo académico citado.

– ref. Beber para encajar: por qué el consumo de alcohol juvenil no solo depende de una decisión personal – https://theconversation.com/beber-para-encajar-por-que-el-consumo-de-alcohol-juvenil-no-solo-depende-de-una-decision-personal-285655

Volver a Jane Austen: cómo la serie ‘La otra hermana Bennet’ cambia nuestra lectura de ‘Orgullo y prejuicio’

Source: The Conversation – (in Spanish) – By Rosa García-Periago, Profesora de Literatura Inglesa, Universidad de Murcia

Imagen de Ella Bruccoleri como Mary Bennet en _La otra hermana Bennet_. Movistar

“Es una verdad universalmente reconocida que un hombre soltero en posesión de una gran fortuna necesita una esposa”. Pocas frases de la literatura son tan famosas como el comienzo de Orgullo y prejuicio. Pero La otra hermana Bennet, la nueva serie de la BBC (que en España emite Movistar), ha decidido sustituirla por otra muy distinta: “Es un hecho triste de la vida que, si una joven tiene la desgracia de venir al mundo sin perspectivas de futuro, más le vale hacer todo lo posible por ser hermosa”.

No es un simple cambio de estilo. Con esa frase, la serie deja claro que no quiere limitarse a volver a contar una historia conocida. Quiere invitarnos a leer desde otra perspectiva.

Portada de _La otra hermana Bennet_ de Janice Hadlow.

Libros de seda

En realidad, la serie adapta el libro homónimo de Janice Hadlow, una novela que imagina la vida de Mary Bennet, una de las hermanas a la sombra de Lizzy (protagonista de la obra de Austen). Ese detalle resulta revelador. Antes de llegar a la televisión, alguien sintió la necesidad de volver a Orgullo y prejuicio para contar otra historia.

Pero, por supuesto, Hadlow no es la única.

Un clásico que se sigue reinterpretando

Orgullo y prejuicio es una novela que ha dado lugar a multitud de reescrituras de ficción. Numerosos escritores y escritoras han vuelto al universo creado por Jane Austen para imaginar precuelas, secuelas, trasladar sus historias a otros contextos como al Pakistán contemporáneo o explorar personajes que aparecían en los márgenes del relato original.

Todos estos textos parten de una misma idea: un clásico nunca es un texto cerrado. Cada generación puede volver a él y formular nuevas preguntas.

Llama la atención que muchas de las reescrituras más recientes de Orgullo y prejuicio tienden a dar voz a personajes que apenas ocupaban unas páginas en la novela original. Entre ellos destacan, sobre todo, personajes femeninos como Anne de Bourgh (la hija de Lady Catherine de Bourgh, idealmente destinada a casarse con el protagonista, Mr. Darcy), Charlotte Lucas (la amiga pragmática de Lizzy Bennet que decide que un matrimonio conveniente es mejor que nada) y, por supuesto, Mary Bennet. En todos estos casos, la idea es similar: mirar una historia que creíamos conocer desde otro lugar.

¿Y si Mary Bennet siempre hubiera sido algo más?

La otra hermana Bennet resulta especialmente interesante porque elige como protagonista a Mary Bennet, probablemente uno de los personajes menos comprendidos de Orgullo y prejuicio.

Durante generaciones, a Mary, que buscaba leer y cultivar el intelecto, se la ha recordado como la hermana pedante, poco agraciada y que desafina. Se mostraba como un personaje cómico que contrastaba con la ingeniosa Lizzy o la bella Jane. Incluso las adaptaciones cinematográficas promovían esta imagen de Mary.

Cinco mujeres vestidas de la época de la regencia inglesa.
Las cinco hermanas Bennet en la serie La otra hermana Bennet con Mary en el centro.
Movistar +

Quizá por eso tantos escritores han querido darle una segunda vida. Ha viajado por Inglaterra y se ha visto envuelta en peligros y escándalos políticos, ha sido espía del gobierno británico e incluso la han imaginado enamorada del enigmático Víctor Frankenstein y entablando una amistad muy extraña con la criatura.

Janice Hadlow lleva esa idea un paso más allá. Su novela plantea una pregunta sencilla pero muy interesante: ¿y si Mary no fuera realmente un personaje cómico, como se nos ha hecho creer, sino alguien a quien nunca habíamos mirado desde la perspectiva adecuada?

Esta reescritura no cambia los acontecimientos fundamentales de Orgullo y prejuicio. Lo que cambia es nuestra posición como lectores. Multitud de escenas adquieren un nuevo significado cuando observamos la historia desde la experiencia de Mary.

Ese cambio de perspectiva también transforma nuestra lectura de los demás personajes. Elizabeth “Lizzy” Bennet es mucho más que una heroína ingeniosa que ha conquistado a generaciones de lectores. Es también una persona capaz de ignorar o malinterpretar a quien tiene más cerca. La serie no destruye nuestra imagen de Elizabeth, sino que la hace más compleja.

Los clásicos no cambian, nuestra lectura sí

Normalmente pensamos que los clásicos son inmutables y que son los nuevos trabajos los que los alteran. Sin embargo, no es tan sencillo. La relación funciona en ambas direcciones.

Cada nueva historia que se basa en una anterior, también altera, inevitablemente, nuestra lectura de esa obra. Pero ¿por qué ciertas historias vuelven una y otra a ser reescritas? La investigadora Erin Sullivan señala que los clásicos que son permanentemente reescritos actúan como un “barómetro” de los cambios culturales: regresar a ellos permite observar no sólo qué sigue igual sino, sobre todo, qué ha cambiado en la sociedad que los vuelve a leer.

Uno de esos cambios tiene que ver con la relación que tenemos con el canon. Los clásicos no sólo deben verse como obras que haya que conservar intactas, sino también como textos con los que podemos dialogar, e incluso discrepar. Es interesante volver a esas historias conocidas desde puntos de vista que antes quedaban fuera. Así, las experiencias de quienes han sido relegados por razones de clase, raza, género o sexualidad adquieren una nueva visibilidad que no tenían en los relatos originales. Las reescrituras permiten preguntarnos quién tenía voz en una historia y quién no.

Pero para que una reescritura funcione hace falta algo más que un clásico conocido. También hace falta que la obra ofrezca posibilidades que se puedan volver a explorar: personajes secundarios con historias apenas divulgadas, situaciones con otras interpretaciones posibles o silencios que nos permitan imaginar qué sucedía fuera del texto original.

Es lo que ocurre en Ancho mar de los Sargazos, en el que Jean Rhys vuelve a la novela Jane Eyre para contar la historia de Bertha Mason; en Penélope y las doce criadas, donde Margaret Atwood cuenta la Odisea desde la perspectiva de Penélope; y en James, en el que Percival Everett reescribe Las aventuras de Huckleberry Finn desde la perspectiva de Jim, el esclavo fugitivo de la novela original. No son simplemente versiones nuevas de historias antiguas: son también una manera de preguntarnos qué otros relatos estaban incluidos en ellas y nunca vimos.

Portadas de los libros James, El ancho mar de los Sargazos y Penélope y las doce criadas.
Algunos ejemplos de reescrituras modernas de clásicos del canon.
De Conatus/Penguin Books

Después de leer o ver La otra hermana Bennet es prácticamente imposible volver a Orgullo y prejuicio sin prestar más atención a Mary. Obviamente, la novela de Austen no ha cambiado, pero nuestra lectura sí.

Quizá por eso resulta tan significativo que la serie empiece cambiando una de las frases más conocidas de la literatura. No pretende reemplazar las palabras de Austen ni sugerir que su comienzo era incompleto. Lo que hace es recordarnos que incluso una frase que creíamos definitiva puede abrir la puerta a nuevas lecturas.
“Es una verdad universalmente reconocida que un hombre soltero en posesión de una gran fortuna necesita una esposa” seguirá siendo el comienzo de Orgullo y prejuicio. Pero, después de acompañar a Mary Bennet en su propia historia, resulta inevitable preguntarse qué estaba ocurriendo mientras seguíamos a Lizzy.


¿Quiere recibir más artículos como este? Suscríbase a Suplemento Cultural y reciba la actualidad cultural y una selección de los mejores artículos de historia, literatura, cine, arte o música, seleccionados por nuestra editora de Arte + Humanidades Claudia Lorenzo.


The Conversation

Este artículo es fruto del Proyecto 22623/PI/24 “Film And Fiction: Adaptation And Rewriting (Cine y Ficción: Adaptación y Reescritura),” concedido por la Fundación Séneca.

– ref. Volver a Jane Austen: cómo la serie ‘La otra hermana Bennet’ cambia nuestra lectura de ‘Orgullo y prejuicio’ – https://theconversation.com/volver-a-jane-austen-como-la-serie-la-otra-hermana-bennet-cambia-nuestra-lectura-de-orgullo-y-prejuicio-290475

Tápers seguros: cómo evitar los microbios cuando hacemos ‘batch cooking’

Source: The Conversation – (in Spanish) – By Raúl Rivas González, Catedrático de Microbiología. Miembro de la Sociedad Española de Microbiología, Universidad de Salamanca

Okrasiuk/Shutterstock

En los países desarrollados, mantener una alimentación sana es un reto para la sociedad moderna, entre otras cosas porque la falta de tiempo suele empujarnos a echar mano de los ultraprocesados. Una alternativa en auge es practicar lo que se conoce como batch cooking, es decir, cocinar en lote, durante una sola sesión, lo que consumiremos a lo largo de toda la semana.

Aunque esta práctica ha sido popularizada en la última década, como una tendencia urbana impulsada por la aceleración de los ritmos de vida, la búsqueda de eficiencia temporal y la gestión del presupuesto familiar, hunde sus raíces históricas en las técnicas de conservación masiva tradicionales y en la logística de raciones del meal prep industrial del siglo XX. Éste se refería a la estandarización, producción en cadena y empaquetado de porciones individuales de comida, diseñadas para ser almacenadas, transportadas y consumidas de forma rápida.

El modelo nació de la logística militar durante la Segunda Guerra Mundial, periodo en el que alimentar a millones de soldados requirió transformar la cocina tradicional en una ciencia de distribución cuantitativa e incluir las famosas raciones de campo. Con ellas, los ejércitos lograron ofrecer menús calculados al milímetro en términos de calorías, grasas y proteínas, sellados en recipientes impermeables o latas que no requerían refrigeración.

Esta novedad impulsó avances técnicos cruciales en la industria alimentaria, entre los que destacaron el sellado al vacío, la congelación rápida, la liofilización y el ensamblaje en cadena. Avances que ahora se aplican a las cocinas de fábricas, hospitales y comedores escolares.

Sí se puede enfriar comida en la nevera

Si bien es cierto que el batch cooking puede ahorrar tiempo y dinero, esta práctica de cocinar en lote para toda la semana plantea serios desafíos en materia de inocuidad alimentaria cuando no se controlan con rigor las diversas variables microbiológicas. El principal factor de riesgo tiene que ver con la permanencia prolongada de los alimentos dentro de la zona de peligro térmico, situada entre 5 °C y 60 °C. Este rango favorece la germinación de esporas y la proliferación acelerada de bacterias supervivientes al procesado térmico inicial.

Al cocinar grandes volúmenes, las endoesporas de bacterias como Bacillus cereus, común en arroz y pasta, pueden sobrevivir al cocinado inicial y germinar durante un enfriamiento lento a temperatura ambiente, dando lugar a nuevas bacterias que liberan toxinas resistentes al calor. Estas toxinas no se destruyen con un recalentado posterior y pueden causar graves problemas de salud.

¿Cómo lo evitamos? Eligiendo envases adecuados. Los protocolos de organismos oficiales como la Autoridad Europea de Seguridad Alimentaria (EFSA) y la Administración de Alimentos y Medicamentos estadounidense (FDA), aconsejan fragmentar los guisos en recipientes poco profundos que permitan acelerar la transferencia de calor entre el exterior y la comida. Así se garantiza un enfriamiento que baje de 60 °C a menos de 10 °C en menos de dos horas.

La temperatura de una cocina ronda entre 20 °C y 25 °C, un rango insuficiente para que la comida baje de los 10 °C por sí sola, lo que hace necesario el traslado al frigorífico o el uso de un baño de agua con hielo. La idea de que nunca debemos guardar alimentos calientes en la nevera proviene del riesgo que supone introducir ollas grandes con comida caliente, cuya masa térmica eleva la temperatura interna de la nevera y rompe la cadena de frío del resto de los alimentos.

No obstante, se puede introducir comida caliente en la nevera si repartimos la preparación en recipientes poco profundos, porque reduce la carga de calor a un nivel que el electrodoméstico gestiona con seguridad. Para lograr un enfriamiento rápido, conviene reposar la comida antes en esos envases llanos un máximo de 30 minutos sobre la encimera para liberar el vapor más denso, o bien reposar sobre una bandeja con hielo si tenemos más prisa. Tan pronto como disminuya la condensación visible, el recipiente debe pasar al frigorífico para completar el descenso desde 60 °C hasta menos de 10 °C en un lapso inferior a dos horas.

En el interior de la nevera es fundamental dejar espacio entre recipientes para permitir la libre circulación del frío, además de mantener la tapa entreabierta durante el proceso para dejar escapar el calor residual sin exponer la comida a contaminantes, cerrándola por completo una vez fría.

El tiempo total desde que termina la cocción hasta alcanzar una temperatura inferior a 10 °C no debe exceder las dos horas, plazo que baja a solo una hora si la temperatura ambiental supera los 30 °C.

Procediendo de esta manera evitamos también que haga de las suyas Clostridium perfringens, una bacteria que se asocia comúnmente a platos a base de carnes cocinadas, productos cárnicos cocidos, salsas de carnes, estofados, albóndigas, etc. producidos en grandes cantidades y refrigeradas en condiciones no adecuadas.

Hasta 4 días en la nevera

A medida que los alimentos cocinados pasan días en la nevera, el principal riesgo lo representa Listeria monocytogenes, un patógeno psicrótrofo capaz de multiplicarse lentamente incluso a temperaturas de refrigeración, convirtiendo las preparaciones guardadas durante más de cuatro o cinco días en un peligro significativo.

Por eso conviene limitar la conservación en refrigeración (≤ 4 °C) a un máximo de 3 a 4 días. Y congelar a -18 °C para períodos superiores. Además, es recomendable someter cada ración individual a un único recalentamiento uniforme que alcance al menos 74 °C en su centro térmico antes del consumo, porque esta temperatura es el estándar internacional de inocuidad alimentaria que garantiza la destrucción térmica instantánea de bacterias patógenas en su forma vegetativa, como Listeria monocytogenes, Salmonella, Escherichia coli y Campylobacter.

Las patatas en nevera cambian sus propiedades

Más allá del peligro microbiológico, el batch cooking tiene singularidades químicas y organolépticas de gran relevancia. Por ejemplo, el almacenamiento y posterior recalentamiento de carnes cocinadas desencadena la degradación lipídica conocida como warmed-over flavor (sabor a recalentado), que genera notas desagradables a rancio, cartón o viejo, debido a la oxidación de los ácidos grasos insaturados catalizada por el calor y el hierro libre.

También los platos que contienen patata cambian de textura en nevera. El cambio deriva de las transformaciones fisicoquímicas de los carbohidratos y la arquitectura celular del tubérculo. Durante la cocción, la gelatinización provoca que los gránulos de almidón absorban agua y aumenten de volumen, otorgando la consistencia blanda inicial. Al enfriar el plato mediante el batch cooking, los polímeros de amilosa y amilopectina experimentan una retrogradación, y el tejido se vuelve firme, harinoso o gomoso.

Esta reestructuración hace que se expulse la humedad atrapada. Como consecuencia se reseca la pulpa interna, la superficie exterior se humedece y se desestabiliza las salsas de los guisos con patata. La congelación intensifica el deterioro, porque la formación de cristales de hielo fractura las paredes celulares, provocando el colapso estructural y la aparición de una masa pastosa al descongelar.

The Conversation

Raúl Rivas González no recibe salario, ni ejerce labores de consultoría, ni posee acciones, ni recibe financiación de ninguna compañía u organización que pueda obtener beneficio de este artículo, y ha declarado carecer de vínculos relevantes más allá del cargo académico citado.

– ref. Tápers seguros: cómo evitar los microbios cuando hacemos ‘batch cooking’ – https://theconversation.com/tapers-seguros-como-evitar-los-microbios-cuando-hacemos-batch-cooking-273129

Mille millions de mille cyborgs ! Pourquoi les pirates informatiques demandent de plus en plus de rançons en cryptomonnaies

Source: The Conversation – in French – By Pierre-Charles Pradier, Maître de conférences en Sciences économiques, LabEx RéFi, Université Paris 1 Panthéon-Sorbonne


L’ESSENTIEL

  • Les rançongiciels, ces logiciel bloquant l’accès à un ordinateur en volant ses données en échange d’une rançon, ont rapporté plus de 800 millions de dollars en 2025.

  • Pour partir avec leur butin, les pirates du Web passent de plus en plus par les cryptomonnaies, plus rémunératrices et moins traçables.

  • Les positions ambiguës des États, comme la Russie, l’Iran et la Corée du Nord, brouillent encore plus les pistes pour les gendarmes financiers.


Cet été, une cyberattaque d’ampleur a touché le système d’information de la Direction générale des finances publiques (DGFiP) avec le vol de données fiscales et cadastrales de 678 000 particuliers et professionnels. Les fuites : noms, prénoms, adresses postales, numéros de téléphone, situation familiale, quotient familial, revenu fiscal de référence et taux de prélèvement à la source.

Cette attaque n’est pas isolée. L’extorsion grâce aux logiciels rançonneurs est une activité qui en 2025 rapporterait à ceux qui la pratiquent un butin de 820 millions de dollars états-uniens issus des paiements de rançons en cryptomonnaies. En France, l’Agence nationale de la sécurité des systèmes d’information (ANSSI) constate 128 attaques majeures en 2025, touchant principalement les petites et moyennes entreprises.

Les pirates, aux noms de Qilin, TheGentlemen ou DragonForce, implantent dans les ordinateurs des victimes un logiciel rançonneur qui en chiffre les unités de stockage (comme les disques durs) et exfiltre ces données. Les pirates les font ensuite payer pour la récupération de ces fichiers informatiques. On parle alors de simple extorsion.

Pour les particuliers, l’affaire s’arrête en général ici. Pour les entreprises, l’histoire est tout autre. Elles doivent verser une rançon pour échapper à la diffusion de leurs données, souvent sensibles, qui ont été volées. Cette fois-ci, on parle de double extorsion.

Les chapeaux noirs – nom donné aux pirates informatiques – peuvent leur demander enfin de s’acquitter d’un lourd tribut afin de ne pas subir de nouvelles attaques. Ces dernières peuvent prendre la forme de déni de service, en saturant les réseaux de requête, rendant de facto le serveur ou le site web inaccessible. On parle pour ce « forfait complet » de triple extorsion.

Alors comment est née cette cybercriminalité ? Combien pèse-t-elle économiquement ? Et pourquoi les pirates numériques utilisent les cryptomonnaies pour être payés ?

Aux origines des rançongiciels

En décembre 1989, le premier rançongiciel (ransomware) de l’histoire, baptisé « AIDS Trojan » (ou cheval de Troie PC Cyborg) voit le jour. Joseph Popp, salarié de l’Organisation mondiale de la santé (OMS), envoie 26 000 enveloppes, chacune contenant une disquette de « renseignements introductifs sur le sida » à l’ensemble des chercheurs, des institutions médicales et des participants à une conférence internationale sur le sida organisée à Stockholm.

Au bout de 90 redémarrages, un message leur demande de payer une redevance annuelle de 189 dollars pour continuer à utiliser la disquette. Les victimes paniquent.

Écran affiché lors du AIDS Trojan.
Wikimédia

Rattrapé par la Computer Crime Unit de New Scotland Yard, Joseph Popp est arrêté, perd la tête en attendant son jugement, avant de se consacrer à l’étude des papillons.

En 1996, Adam Young et Moti Yung soulignent que le schéma inventé par Joseph Popp pourrait « être utilisé pour mener des attaques visant à l’extorsion, avec, comme conséquence possible, la perte d’accès aux informations ».

De cette cybercriminalité artisanale émerge une véritable industrie du rançongiciel, avec CryptoLocker en 2013 – bloqueur d’écran –, Locky en 2016 – millions de courriels de phishing par jour – puis Lockbit en 2019 – menace de publication des données avec le système de Ransomware-as-a-Service (RaaS).

Extorsion lucrative

Aujourd’hui, l’industrie des rançongiciels est une manne financière extrêmement lucrative. Trois principaux organismes en étudient les coûts comme le rappelle l’économiste Anja Shortland : le FBI, Financial Crime Enforcement Network (FINCEN) et Chainalysis.

Le FBI compile les déclarations réalisées via l’Internet Crime Complaint Center. Cependant, comme il l’indique dans ses rapports depuis 2018, « dans certains cas, les victimes ne déclarent aucune perte au FBI, ce qui diminue artificiellement le chiffre des pertes ». L’administration états-unienne Financial Crime Enforcement Network (FINCEN) consolide les déclarations de soupçon des entreprises réglementées, notamment les cabinets spécialisés en réponse aux incidents et en expertise numérique criminelle, qui sont sollicités par les entreprises attaquées. Chainalysis analyse la chaîne de blocs des protocoles cryptos qui servent à payer les rançons et publie chaque année un rapport sur le crime.

Volume annuel de rançons payées par les victimes de logiciels rançonneurs d’après le FBI, FINCEN, Chainalysis
Produit annuel.
Fourni par l’auteur

Ce tableau nous mène à trois constats :

  • Les estimations du FBI sont très inférieures aux autres, car les entreprises ne déclarent les cyberattaques dont elles sont victimes que si elles y sont contraintes par la loi. L’économiste Anja Shorland rappelle que ces entreprises sont réticentes pour ne pas donner une mauvaise image de leur organisation.

  • Les trois méthodes convergent pour montrer que l’activité est peu perceptible avant 2016 et qu’elle explose en 2020.

  • Ces estimations sont des minorants. Elles mesurent seulement les sommes payées par les victimes, pas les dégâts encourus – pertes de données, de chiffre d’affaires, d’image, pertes des sous-traitants, coût de remise en marche. Alors qu’aucune rançon n’a été versée, la seule attaque contre Jaguar Land Rover en août 2025, aurait coûté plus de 350 millions à JLR et six fois plus à ses milliers de sous-traitants.

Il n’y a pas d’évaluation académique globale des coûts complets, même si des méthodologies ponctuelles sont élaborées et des consultants en cybersécurité avancent des chiffres en dizaines de milliards de dollars états-uniens par an.

Baisse des coûts et diminutions de la traçabilité grâce au bitcoin

On peut toutefois se demander pourquoi et comment les exploitants de ces logiciels d’extorsion ont choisi d’utiliser Bitcoin pour le paiement des rançons, alors que la chaine de bitcoin permet de tracer les paiements.

Le chercheur Nori Katagiri souligne que si les criminels ont abandonné l’usage des numéros de téléphone surtaxés et des cartes prépayées c’est d’abord en raison d’un « facteur d’échelle » qui permettait d’augmenter le niveau des rançons.

L’affaire du hacker Zain Qaiser, condamné le 9 avril 2019 à Londres, éclaire à plus d’un titre. Cet étudiant faisait croire à des victimes qu’il possédait des enregistrements de leurs visites sur des sites pornographiques. Son complice installé aux États-Unis facturait ses services de blanchiment environ 30 % du montant des sommes traitées. C’est précisément ce complice qui s’est fait attraper par les autorités américaines.

Au bout du compte, Zain Qaiser aurait gagné un peu moins d’un million de dollars en deux ans avant son arrestation. En parallèle, les pirates derrière Cryptolocker, les premiers à se faire payer en bitcoins dès novembre 2013, auraient engrangé 8 millions de dollars en moins de six mois sans se faire inquiéter. Ceux de Locky, 27 millions en 2016. Le Financial Crimes Enforcement Network (FINCEN) aux États-Unis a comptabilisé 250 millions de dollars pour Lockbit et près de 400 pour ALPHV/BlackCat.

On a manifestement changé d’échelle avec l’usage des cryptomonnaies !

Utilisation de plateformes d’échanges complaisantes

Les criminels utilisent des prestataires de services liés aux cryptomonnaies qui ne se soucient pas des recommandations du Groupe d’action financière (GAFI), l’organisme mondial de surveillance et de normalisation chargé de lutter contre le blanchiment de capitaux.

La liste est longue des plateformes d’échange russes poursuivies sanctionnées par les États-Unis pour leur contribution au blanchiment de l’argent des rançons : BTC-e dès 2017, Suex en septembre 2021, Garantex en 2022, Bitzlato en 2023 ou PM2BTC en 2024.

Les pirates, quand ils sont reconnus, font aussi l’objet d’actes d’accusation et de demandes d’extradition, comme c’est le cas par exemple pour Evgeniy Bogachev, le créateur de GameOver Zeus, un cheval de Troie conçu principalement pour dérober des informations bancaires et propager le ransomware CryptoLocker.

Lieux sûrs à l’abri de la justice

Si le bitcoin a longtemps été l’instrument privilégié de règlement des rançons, Monero bénéficie depuis le début des années 2020 d’une popularité croissante. Comme l’indique une étude :

« Les groupes de rançongiciels […] privilégient de plus en plus les options plus anonymes, comme Monero, pour éviter d’être détectés. Les paiements en bitcoins peuvent entraîner des frais supplémentaires. »

Reste qu’avec l’interdiction de Monero dans l’Union européenne – article 76 §3 de MiCA – et l’attention portée par le Financial Crimes Enforcement Network (FINCEN) états-unien à ce protocole, le plus simple reste d’accepter les bitcoins que les victimes peuvent acheter auprès des prestataires légaux dans leur pays.

Le modèle économique du logiciel rançonneur dépend de l’accueil fait par quelques États aux exploitants de logiciels et de plateformes d’échanges qui permettent d’assurer le blanchiment des profits criminels.

La Russie, l’Iran et la Corée du Nord hébergent-ils la fine fleur du logiciel rançonneur, tout en pratiquant le déni, même quand il n’est pas plausible ? La doctrine de ces États consiste à offrir aux cyberattaquants et aux opérateurs de cryptos interlope un lieu sûr (safe harbor) tant qu’ils ne nuisent pas directement aux intérêts nationaux ; quand les États ne déguisent pas en pirates leurs propres agents…

Compte tenu de la difficulté de soumettre ces acteurs à des actions diplomatiques, la lutte contre le logiciel rançonneur ne peut reposer sur les seules victimes et leurs assureurs, comme le montrent les chercheurs Anja Shortland et Tom Baker. Les pouvoirs publics peuvent agir efficacement en invitant les assureurs à limiter les paiements, mais aussi en proposant des normes en matière de cyberdéfense, notamment en promouvant un modèle d’équilibre entre ouverture et sécurité, entre efficacité et résilience.

The Conversation

Pierre-Charles Pradier ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d’une organisation qui pourrait tirer profit de cet article, et n’a déclaré aucune autre affiliation que son organisme de recherche.

– ref. Mille millions de mille cyborgs ! Pourquoi les pirates informatiques demandent de plus en plus de rançons en cryptomonnaies – https://theconversation.com/mille-millions-de-mille-cyborgs-pourquoi-les-pirates-informatiques-demandent-de-plus-en-plus-de-rancons-en-cryptomonnaies-264639

Les faucons russes, idéologues du conservatisme modernisateur

Source: The Conversation – in French – By Juliette Faure, Professeure de science politique, Université de Lille

Depuis les années 1960, des idéologues soviétiques puis russes ont développé une théorie associant traditionalisme et modernisation technologique pour promouvoir un État autoritaire de type stalinien. Leur influence ne résulte pas seulement de la diffusion de leurs idées, mais aussi de leur capacité à s’organiser en réseaux et à tirer parti d’un pluralisme idéologique toujours strictement encadré par le pouvoir. Dans son livre les Faucons russes. Des idéologues au service de l’empire. De 1960 à nos jours, paru le 17 septembre aux Presses universitaires de France, Juliette Faure, professeure de science politique à l’Université libre de Bruxelles, retrace la généalogie de ce mouvement et montre comment, depuis l’invasion de l’Ukraine en 2022, ses thèmes impérialistes, anti-occidentaux et conservateurs ont retrouvé une place centrale. Extraits.


Aux origines du conservatisme modernisateur

Plutôt que de reprendre la division classique entre période soviétique et période postsoviétique, j’ai souhaité souligner la continuité historique des années 1960 à aujourd’hui. Au cours de cette séquence, les faucons russes élaborent et diffusent un nouveau langage idéologique, le « conservatisme modernisateur », qui associe traditionalisme religieux et modernisation technologique au service d’un État autoritaire et impérialiste. L’analyse de la genèse soviétique de ce discours montre qu’il vise à s’opposer aux théories occidentales de la modernisation, selon lesquelles le développement postindustriel conduirait les sociétés à leur convergence vers des institutions libérales. À l’inverse, les faucons soutiennent que l’Union soviétique, puis la Russie, doivent suivre une trajectoire de modernisation distincte, conciliant progrès technologique et valeurs présentées comme spécifiquement russes. […]

Le conservatisme modernisateur apparaît moins comme un corpus doctrinal parfaitement cohérent que comme un langage collectif capable de fédérer des groupes et des générations réunis par leur refus de la convergence avec l’Occident et par leur positionnement commun dans la compétition politique. À la fin de l’URSS, ce langage devient le référent identitaire d’une première génération de faucons, composée d’intellectuels nostalgiques de l’empire tsariste et de représentants de l’establishment politique et militaire soviétique hostiles aux réformes.

Malgré leur diversité sociale et idéologique, ces acteurs partagent une même expérience de mobilisation contre les réformateurs libéraux, à travers la publication de manifestes, la formation de coalitions électorales ou encore leur participation au coup d’État d’août 1991 contre Mikhaïl Gorbatchev. Leur échec politique n’entraîne pas la disparition du groupe : le conservatisme modernisateur continue de structurer leur identité collective durant toute la transition postsoviétique. Une deuxième génération de faucons, les « Jeunes Conservateurs », émerge au début des années 2000. Elle reprend la critique de l’horizon de convergence en dénonçant à la fois l’hégémonie occidentale sur l’ordre international et l’intégration de la Russie dans l’économie mondiale.

À nouveau, la cohésion de ce groupe se constitue malgré sa diversité idéologique interne, qui va de l’impérialisme orthodoxe à l’ethno-nationalisme laïque, et se construit sur un socle d’idées partagées autant que sur une volonté commune de supplanter l’influence de groupes libéraux dans la sphère médiatique et dans la production d’expertise en politiques publiques. Formés aux sciences sociales et devenus des contributeurs actifs dans les médias en ligne, ils se professionnalisent comme intellectuels publics et systématisent l’héritage de leurs prédécesseurs en une idéologie structurée, qu’ils désignent sous le nom de « conservatisme dynamique ». La création du club d’Izborsk en 2012 réunit ces deux générations. Le club transforme ainsi un ensemble relativement dispersé d’intellectuels en un réseau idéologique institutionnalisé, qui défend la restauration de la Russie comme grande puissance impériale par une confrontation culturelle, politique et militaire avec l’Occident. […]

Un pluralisme idéologique sous contrôle étatique

Malgré l’interdiction d’une idéologie d’État inscrite dans la Constitution de 1993, le régime russe restaure progressivement, dès le milieu des années 1990, des formes de parrainage étatique de production idéologique qui rappellent certaines pratiques soviétiques. Il ne reconstitue toutefois pas un appareil idéologique centralisé comparable à celui du Parti communiste. Il privilégie plutôt des relations transactionnelles avec des clubs, des fondations, des think tanks et d’autres entrepreneurs idéologiques situés à la périphérie des institutions étatiques et partisanes. […]

Le soutien de l’État à la production idéologique ne vise pas à imposer une doctrine unique, mais à organiser un certain degré de pluralisme sous contrôle autoritaire. Si un noyau discursif s’est progressivement stabilisé autour de thèmes tels que la puissance de l’État, la souveraineté ou la multipolarité de l’ordre international, d’autres contenus idéologiques demeurent évolutifs. Ce « pluralisme idéologique dirigé » s’appuie sur la promotion ou la marginalisation sélective de réseaux concurrents. En modulant l’accès de ces groupes aux ressources publiques, aux institutions et à la visibilité médiatique, le pouvoir conserve un répertoire de références suffisamment diversifié pour justifier des orientations parfois contradictoires. Cette configuration permet ainsi la coexistence de politiques économiques d’inspiration libérale – comme celles qui conduisent à l’adhésion de la Russie à l’Organisation mondiale du commerce en 2012 – avec une politique étrangère de plus en plus critique à l’égard des normes libérales internationales. […]

Plutôt que d’évaluer l’adhésion d’un régime à une idéologie conçue comme doctrine abstraite ou ensemble figé de croyances, cette perspective invite à analyser la manière dont le pouvoir organise et régule une sphère de production idéologique traversée par une pluralité d’acteurs. Au sein de cette sphère, j’identifie deux dimensions clés à travers lesquelles l’idéologie influence l’orientation des politiques de l’État russe.

La première dimension est structurelle. L’idéologie constitue le langage collectif à travers lequel des groupes d’élites se reconnaissent, se coordonnent et construisent leurs identités politiques. Elle ne se limite pas à définir des préférences ; elle contribue à structurer les clivages, à organiser les coalitions et à délimiter les frontières entre groupes cherchant à influencer les décideurs. Les faucons ont activement travaillé cet espace de compétition politique. J’ai montré qu’ils ont poursuivi une stratégie d’inspiration gramscienne : plutôt que de privilégier l’action partisane directe, ils ont cherché à conquérir une hégémonie culturelle dans la sphère publique afin d’influer indirectement sur les décisions des élites dirigeantes. […]

La fondation du club d’Izborsk en 2012 constitue l’aboutissement de cette évolution. En réunissant les deux générations de faucons, le club consolide une infrastructure capable d’agréger des ressources intellectuelles, organisationnelles et financières afin de concurrencer les réseaux libéraux dans le champ de l’expertise publique. L’accroissement de sa visibilité, de sa légitimité et de sa reconnaissance institutionnelle montre que les transformations de l’environnement idéologique ne résultent pas uniquement de la diffusion de nouvelles idées, mais aussi du travail organisationnel par lequel certains groupes parviennent à modifier durablement les rapports de force qui structurent l’environnement politique dans lequel les décisions étatiques sont prises.

La seconde dimension de l’influence politique de l’idéologie est d’ordre instrumental. […] Les élites au pouvoir sélectionnent des entrepreneurs idéologiques, soutiennent leur production et intègrent certaines de leurs idées afin de légitimer des choix de politique intérieure et extérieure. La gestion du pluralisme idéologique par le régime – tantôt accentuant la polarisation, tantôt la modérant – accompagne ainsi l’évolution de ses orientations politiques, qui oscillent entre ouverture prudente à la coopération avec l’Occident et affirmation d’une posture de confrontation.

L’ascension des faucons ne résulte donc pas uniquement de leurs propres stratégies de mobilisation. Elle dépend également des modalités selon lesquelles le pouvoir redéfinit ses alliances idéologiques en réponse à des crises qui remettent en cause sa légitimité, son autorité ou sa perception de l’environnement international. […]

La tendance générale observée depuis le milieu des années 1990 est celle d’un rapprochement progressif entre les faucons et les élites au pouvoir. Leur idéologie devient un répertoire central dans lequel le régime puise pour justifier ses choix politiques. Toutefois, cette dynamique n’est pas linéaire. Le soutien de l’État aux réseaux faucons connaît des phases d’expansion et de reflux, et il s’est sensiblement réduit dans les années précédant l’invasion de l’Ukraine. Lors de mon dernier séjour à Moscou, achevé en décembre 2019, les dirigeants du club d’Izborsk faisaient unanimement état de leur isolement et de leur mise à l’écart des principaux centres décisionnels. Cette perception est corroborée par le refus répété de l’administration présidentielle, à partir de 2016, d’accorder au club les financements qu’il sollicitait. À la veille de l’invasion de l’Ukraine, rien ne permettait donc de considérer son ascension comme irréversible.

Les Faucons russes. Des idéologues au service de l’empire. De 1960 à nos jours. Juliette Faure.
Presses universitaires de France

La guerre d’invasion, consécration des faucons

La décision prise par Vladimir Poutine, le 24 février 2022, d’engager une guerre d’agression contre l’Ukraine constitue dès lors une rupture majeure. L’abandon de la stratégie de négociation autour des accords de Minsk, au profit d’un recours assumé à la force, réactive des ressources idéologiques que le club d’Izborsk défend depuis de nombreuses années. Loin de résulter d’une progression continue de leur influence, ce basculement traduit une nouvelle reconfiguration des relations entre le pouvoir et les entrepreneurs idéologiques, dans laquelle les thèmes impérialistes, anti-occidentaux et conservateurs acquièrent une position hégémonique. […]

Cette évolution ne conduit cependant pas à la reconstitution d’un appareil idéologique entièrement centralisé et cohérent. Le régime continue de s’appuyer sur des partenariats avec des entrepreneurs idéologiques situés en dehors des institutions étatiques, ce qui maintient des formes de concurrence entre différents acteurs chargés de produire et de diffuser les discours légitimes.

Enfin, malgré le durcissement autoritaire et les contraintes imposées par la guerre, la polarisation du champ intellectuel ne disparaît pas. Elle se recompose autour de l’opposition entre les réseaux idéologiques soutenant la guerre et les communautés d’intellectuels émigrés, qui poursuivent depuis l’étranger un travail de critique des fondements idéologiques du régime.

Ces résultats invitent à repenser la place de la Russie dans le système international. Plutôt qu’un acteur monolithique doté de préférences stables, l’État russe apparaît traversé par des répertoires idéologiques divers et évolutifs, dont l’influence varie au gré des recompositions internes des élites et des transformations de l’environnement international. L’étude de la compétition entre réseaux d’acteurs contribue ainsi à rendre les orientations de l’État plus contingentes qu’il n’y paraît, certaines conceptions de la puissance, de la sécurité ou de l’identité nationale pouvant s’imposer, reculer ou être réactivées selon les rapports de force politiques.

The Conversation

Juliette Faure ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d’une organisation qui pourrait tirer profit de cet article, et n’a déclaré aucune autre affiliation que son organisme de recherche.

– ref. Les faucons russes, idéologues du conservatisme modernisateur – https://theconversation.com/les-faucons-russes-ideologues-du-conservatisme-modernisateur-290015

Pourquoi Nutri-Score, labels et allégations ne suffisent-ils pas à faire aimer les produits sains ?

Source: The Conversation – in French – By Raouf Zafri, Maître de Conférences en sciences de gestion, spécialisé en marketing, Université Paris 1 Panthéon-Sorbonne


L’ESSENTIEL

  • Nutri-Score, applications de notation, labels… l’information est censée favoriser les produits de meilleure qualité nutritionnelle.

  • Mais rendre plus visibles les produits les plus sains, notamment par des indices sur les emballages, ne suffit pas toujours à susciter l’adhésion.

  • L’expérience sensorielle (liée au goût, à la texture, etc.) doit être améliorée avec les produits les meilleurs pour la santé pour qu’ils soient davantage choisis.


Avec l’appui des pouvoirs publics, nous n’avons jamais eu autant d’informations pour mieux manger : Nutri-Score, labels, allégations nutritionnelles ou encore applications de notation.


À lire aussi :
Pourquoi Danone retire le Nutri-Score de ses yaourts à boire


Cette évolution est utile. Elle rend l’information alimentaire plus visible, plus simple à comprendre et plus facile à comparer. Pourtant, une question demeure. Si nous sommes de mieux en mieux informés, pourquoi les produits meilleurs pour la santé peinent-ils encore à devenir des choix évidents, répétés et désirés ?

Un décalage entre l’intention de manger sainement et ce que l’on consomme

Au-delà de la question du prix, de nombreuses enquêtes montrent que les consommateurs déclarent vouloir mieux manger. Cependant, lorsqu’il s’agit d’acheter concrètement un aliment, le goût demeure de loin le critère le plus déterminant pour 85 % des consommateurs, devant la dimension santé, citée par 62 % d’entre eux, si on en croit une enquête menée aux États-Unis.

Ce décalage entre l’intention de manger sainement et la recherche de plaisir n’est pas nouveau. Certains travaux scientifiques l’expliquent par ce que l’on appelle « la pénalité hédonique » des produits sains. Derrière ce terme, l’idée est simple. Dès qu’un aliment est présenté comme meilleur pour la santé, il est spontanément jugé moins gourmand et moins agréable, avant même d’être goûté. À l’inverse, un produit perçu comme moins sain semble souvent plus attirant. Avant même d’être goûté, il donne déjà l’impression d’être plus savoureux, plus généreux et plus plaisant.

Bien que cette explication de « la pénalité hédonique » soit éclairante, elle reste incomplète. Elle parle surtout de ce que le consommateur imagine avant l’achat, lorsqu’il ne connaît pas encore le produit.

Des aliments jugés sur des indices « extrinsèques » et « intrinsèques »

Or, en alimentation, le jugement ne s’arrête pas à l’emballage. Il se prolonge après l’achat, au moment de la dégustation. Une fois le produit goûté, le consommateur ne juge plus seulement une promesse. Il évalue aussi une texture, un arôme, un moelleux, une sécheresse, une dureté, une sensation concrète. Ces perceptions enrichissent son jugement et influencent ensuite son comportement futur, qu’il s’agisse de continuer à acheter le produit ou de s’en détourner.

C’est précisément ce point que notre étude, présentée en mai 2026 au 42ᵉ Congrès international de l’Association française du marketing, tente d’approfondir. Le problème d’adoption des produits plus sains ne vient pas seulement des croyances associées au « sain » avant l’achat. Il se construit aussi dans le temps, au fil de l’expérience de consommation.

Cette idée rejoint la théorie des indices intrinsèques et extrinsèques. Les indices extrinsèques sont les éléments qui entourent le produit comme la marque, le packaging, le label ou l’allégation nutritionnelle. Les indices intrinsèques correspondent aux caractéristiques du produit lui-même comme le goût, la texture et la saveur.

Cette théorie nous indique qu’avant l’achat, lorsque le consommateur ne connaît pas encore le produit, son jugement repose largement sur les indices extrinsèques qu’il peut percevoir. Ainsi, un Nutri-Score favorable, par exemple, peut rassurer. Une promesse santé peut attirer l’attention. Un label peut donner envie d’essayer. Ces repères jouent donc un rôle important dans le premier choix.


À lire aussi :
Le succès des applis de scans alimentaires comme Yuka à l’ère de la défiance


Néanmoins, après la dégustation, les choses changent. Les indices intrinsèques deviennent beaucoup plus déterminants car ils sont plus concrets, directement ressentis et immédiatement vérifiables à l’inverse des éléments extrinsèques qui restent plus abstraits pour le consommateur. C’est notamment le cas de la promesse de santé, plus difficile à évaluer au moment de la dégustation.

Pour aller plus loin dans cette réflexion, il nous fallait donc observer les consommateurs au moment où ils goûtent réellement le produit. Car c’est là que l’on voit si la promesse santé résiste encore face à l’expérience en bouche.

(On rappellera que le ressenti, positif ou négatif, lors de la dégustation d’un produit alimentaire n’est pas un indicateur de sa qualité nutritionnelle. On peut apprécier les aliments qui contiennent beaucoup de sucre, de sel ou de matières grasses-les lipides, pour reprendre le terme scientifique- alors qu’en excès, leurs effets négatifs sur la santé ne sont plus à démontrer, ndlr).

Une expérimentation avec des barres de céréales chocolatées

Pour ce faire, nous avons mené une expérimentation sur une catégorie de produit courante : les barres de céréales chocolatées.

L’étude s’est déroulée en trois temps.

D’abord, les participants ont goûté quatre barres de céréales chocolatées à l’aveugle. Ils ne voyaient ni la marque, ni le packaging, ni aucune information nutritionnelle. Les produits étaient présentés de manière neutre. Les participants devaient simplement indiquer dans quelle mesure ils appréciaient chaque barre.

Ensuite, ils ont goûté à nouveau les mêmes produits, toujours à l’aveugle. Cette fois, l’objectif était de comprendre ce qu’ils ressentaient précisément en bouche. Les participants devaient donc évaluer plusieurs sensations : le moelleux, la dureté, le croustillant, la sécheresse, l’intensité aromatique, le niveau sucré, le caractère collant ou encore le côté fade.

Enfin, les participants ont dégusté une dernière fois les produits. Cette fois, deux des barres étaient présentées comme ayant un positionnement plus sain tandis que les deux autres étaient proposées sans cette mention. L’objectif était alors de déterminer si le fait de présenter un produit comme plus sain pouvait modifier son appréciation après dégustation.


À lire aussi :
Aliments ultratransformés : Comment aider les consommateurs à les repérer et à les éviter ?


Les résultats sont très parlants. D’abord, les barres les plus gourmandes (non saines) sont davantage appréciées que celles associées à une promesse plus saine. En revanche, le point le plus intéressant est que cette différence apparaît dès la dégustation à l’aveugle. Les participants ne savaient pas encore quelles barres étaient présentées comme plus saines. Leur jugement ne peut donc pas être expliqué par un préjugé contre les produits « sains ».

De plus, nos résultats montrent que si les produits sains sont moins appréciés, ce n’est pas en raison de leur positionnement santé, mais parce qu’ils sont jugés, en bouche, comme plus secs, plus durs et trop croustillants. À l’inverse, les produits plus gourmands sont appréciés parce qu’ils offrent davantage de moelleux, une intensité aromatique plus marquée, un équilibre sucré plus satisfaisant et une texture plus agréable.

Enfin, lorsque l’information santé est révélée pour les barres « saines », les préférences ne changent pas significativement. Dire qu’un produit est meilleur pour la santé ne suffit donc pas à le rendre plus désirable une fois qu’il a été goûté. L’information nutritionnelle peut attirer l’attention, rassurer et donner envie d’essayer. En revanche, elle ne compense pas une expérience sensorielle décevante.

Repenser les stratégies pour encourager le manger sain

Ce résultat invite à repenser la manière dont on encourage le manger sain. Depuis plusieurs années, les politiques nutritionnelles reposent largement sur l’information. Mieux afficher, mieux expliquer, mieux comparer. Cette logique reste nécessaire. Le Nutri-Score, les labels et les allégations aident les consommateurs à se repérer dans une offre alimentaire complexe. Cela étant, ils ne garantissent pas, à eux seuls, l’adoption durable d’un produit.

Pour les pouvoirs publics et les acteurs de la santé nutritionnelle, l’enjeu est donc de dépasser une approche centrée uniquement sur l’information. Il ne suffit pas de rendre les produits plus sains plus visibles. Il faut aussi encourager des produits plus sains qui restent agréables à manger. Un produit mieux noté, mais perçu comme sec, dur ou fade, risque d’être essayé une fois puis abandonné.

Pour les industriels de l’agroalimentaire, l’enjeu est aussi commercial. Une promesse santé peut favoriser l’essai mais elle ne garantit pas le réachat si l’expérience sensorielle déçoit. L’adoption des offres plus saines se joue donc aussi dans l’expérience en bouche. Les marques doivent ainsi travailler les attributs qui pénalisent le produit, comme, dans notre étude, la sécheresse, la dureté ou un croustillant trop marqué.

Elles doivent aussi renforcer les sensations qui favorisent la préférence comme le moelleux, l’intensité aromatique, un équilibre sucré maîtrisé et une texture plus agréable. Cela passe par des ajustements concrets de formulation, par exemple en travaillant les liants, l’humidité perçue, la granulométrie, la structure du produit ou encore l’équilibre aromatique.

L’enjeu n’est pas seulement de rendre le sain visible. Il est de le rendre suffisamment plaisant pour qu’il trouve sa place dans les habitudes.

The Conversation

Raouf Zafri ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d’une organisation qui pourrait tirer profit de cet article, et n’a déclaré aucune autre affiliation que son organisme de recherche.

– ref. Pourquoi Nutri-Score, labels et allégations ne suffisent-ils pas à faire aimer les produits sains ? – https://theconversation.com/pourquoi-nutri-score-labels-et-allegations-ne-suffisent-ils-pas-a-faire-aimer-les-produits-sains-291509